ИИ-агент может завершить задачу убедительным ответом и при этом пройти к нему ненадёжным путём: выбрать неподходящий инструмент, передать неверные параметры, несколько раз повторить неудачное действие или продолжить работу уже после достижения цели. Поэтому оценка ИИ-агентов не должна сводиться только к проверке финального сообщения. Для многошаговой системы важно разделять как минимум три вещи: что ИИ-агент сообщил пользователю, что реально произошло в системе и каким путём он пришёл к итогу. Такой подход позволяет не просто получить общий балл, а определить источник ошибки — решение модели, параметры операции, траекторию, восстановление при отказе или завершение задачи. Оценка ИИ-агентов поэтому строится вокруг нескольких уровней работы AI-системы. Универсального набора метрик нет: конкретные проверки зависят от задачи, архитектуры, доступных функций и уровня риска. В обычном сценарии работы с LLM объект оценки сравнительно прост: пользователь отправляет запрос, модель возвращает ответ, после чего можно проверить его точность, полноту, релевантность или соответствие инструкции. При оценке больших языковых моделей и других систем искусственного интеллекта часто анализируют свойства отдельного ответа. У ИИ-агента объект оценки шире: между входными данными и итогом появляется многошаговый процесс принятия решений, обращения к сервисам и изменения данных. ИИ-агент может последовательно принимать решения, обращаться к API, искать информацию в базе знаний, изменять записи, учитывать предыдущие шаги и выбирать, продолжать работу или остановиться. Из-за этого финальный текст показывает только часть картины. Представим, что ИИ-агент сообщает: Это output — сообщение пользователю. Но реальный эффект нужно проверять отдельно. Если Когда агенты взаимодействуют с API, CRM, базой данных или другими сервисами, оценивать нужно не только текст ответа, но и последствия совершённых действий. Есть и третий уровень — траектория выполнения (trajectory): последовательность решений и операций, через которую ИИ-агент дошёл до цели. Хороший сценарий может выглядеть так: Другой запуск может закончиться тем же статусом, но пройти иначе: Итог в обоих случаях может совпасть, но качество работы различается. Во втором сценарии были неудачная операция, повтор и лишнее действие. Именно поэтому важно различать текст ответа, фактические изменения и поведение агента. ИИ-агент может утверждать, что задача завершена, хотя запись в базе данных осталась прежней или изменилась не так, как ожидалось. Хороший output не гарантирует правильный outcome, а успешный outcome ещё не гарантирует надёжную работу ИИ-агента. Для диагностики полезнее не искать одну универсальную метрику, а рассматривать несколько уровней работы системы. Оценка ИИ-агентов должна показывать не только качество ответа, но и качество выполнения задач: достигнута ли цель, какие решения принимались и какие действия к ней привели. Такую декомпозицию можно использовать как рабочую модель, но не как единый отраслевой стандарт. Разные AI-платформы используют сходные уровни анализа, однако состав evaluators и конкретные метрики различаются. Часть evaluation относится не к качеству ответа, а к соблюдению заданной политики. Если политика AI-системы разрешает определённую функцию только после подтверждения человека или ограничивает полномочия агента, нарушение такого правила нужно фиксировать отдельно. Если конечный эффект можно объективно подтвердить, начинать стоит с него. ИИ-агент должен создать запись — проверяем её наличие. Должен изменить заказ — смотрим статус. Должен сформировать файл — убеждаемся, что документ действительно появился и соответствует требованиям. Но успешный outcome ещё не заканчивает анализ. Два агента могут прийти к одному итогу разными способами: один — через несколько допустимых операций, другой — через повторы, неверные решения или лишние изменения. Для первой версии системы оценки достаточно контролировать четыре аспекта: Восстановление, остановку, вмешательство человека, стоимость и время можно добавлять по мере роста сложности и риска. Представим dashboard: Такое число удобно как общий индикатор, но плохо объясняет причину отклонения. Неясно, ошиблась ли модель при принятии решения, были ли неверными параметры, не сработал ли API или агент остановился не в тот момент. Поэтому общий score можно использовать для мониторинга или как release gate, но показатели разных уровней лучше сохранять отдельно. Чтобы анализировать многошаговый процесс, его нужно сделать наблюдаемым. Для этого используется трассировка (tracing). В зависимости от платформы trace может фиксировать запросы к модели, обращения к API, параметры, ответы сервисов, временные метки, длительность операций и handoff-события. Так можно видеть, что происходило на каждом шаге. Trace при этом не равен скрытому chain-of-thought. Для оценки достаточно наблюдаемых решений и событий AI-системы. Например: Trace показывает последовательность. Но он не отвечает сам по себе, был ли повтор Tool A необходим. Для этого нужен evaluator, assertion или другое правило контроля. Главная ценность оценки ИИ-агента — возможность определить, на каком этапе возникло отклонение. Первый вопрос — достигнута ли поставленная цель. Если агент сообщает «клиент обновлён», но запись в CRM или базе осталась прежней, уже ясно, на каком уровне искать причину. Каждое действие агента можно разбирать отдельно: какой API или сервис выбран, какие значения переданы, завершилась ли операция и как ИИ-агент использовал ответ. Например: JSON валиден и соответствует схеме. Но если пользователь просил отменить заказ То есть техническая валидность параметров не гарантирует их смысловую точность. Даже если отдельная операция выполнена успешно, следующий шаг может основываться на устаревших или неверно интерпретированных данных. Нужно проверить обязательные действия, порядок шагов, запрещённые операции и использование предыдущих наблюдений. Здесь особенно важно учитывать качество данных. Неполные, устаревшие или противоречивые входные данные могут привести к плохому решению даже тогда, когда сама модель и интеграция работают штатно. Поэтому при анализе AI-агента нужно отделять дефект поведения системы от ситуации, когда причиной стал сам набор входной информации. Timeout, недоступный API или пустой ответ сервиса возможны и в хорошо спроектированной системе. Не каждый отказ означает проблему модели: причина может находиться в интеграции, базе данных, сетевой инфраструктуре или стороннем сервисе. Повторная попытка допустима, если есть основания ожидать успеха. Если же ИИ-агент снова отправляет идентичный запрос, не меняя стратегию, ресурсы и время расходуются без прогресса. Особенно важно контролировать операции, изменяющие данные. При timeout агент может не знать, успел ли предыдущий запрос сработать, и повтор создаст нежелательный второй эффект. ИИ-агент может остановиться слишком рано, сообщить об успехе без подтверждения, зациклиться или продолжить действия, когда цель уже достигнута. Количество шагов нельзя оценивать в отрыве от сценария: для простой операции достаточно нескольких действий, а для сложной исследовательской задачи допустима более длинная цепочка. Как устроен сам цикл принятия решений, подробнее разобрано в материале «Как работает AI-агент: Agent Loop от цели до результата». Интуитивный подход — задать один правильный путь и сравнивать с ним каждый запуск. Для жёстко регламентированного рабочего процесса это полезно: если approval должен предшествовать операции, нарушение порядка имеет значение. Но сложные задачи могут иметь несколько допустимых способов решения. Поэтому вместо полного совпадения с одним эталоном часто лучше контролировать обязательные действия, ограничения, зависимости и допустимые изменения данных. Разные пути могут быть одинаково хорошими, если ИИ-агент соблюдает правила и достигает требуемого эффекта. Оценка должна охватывать не один демонстрационный пример, а разные сценарии использования. Для этого применяют наборы данных, в которые входят реальные задачи из production, типовые пользовательские запросы, граничные случаи, исторические ошибки и специально подготовленные тестовые примеры. В eval set полезно включать разные запросы пользователей, неполные данные, отказы API, ограничения политики, сценарии с обязательным подтверждением и случаи, где важно проверить остановку или восстановление. Качество самого набора также имеет значение: если примеры не отражают реальные рабочие процессы, высокая оценка на тестировании мало говорит о поведении AI-системы в production. Если условие можно проверить кодом, такой подход обычно проще и воспроизводимее. Модель-оценщик полезна там, где нет одного точного эталона и требуется анализ текста или траектории. LLM-as-Judge позволяет масштабировать оценку сложных ответов AI и многошаговых сценариев. Но решения второй модели зависят от критериев, prompt и контекста. Поэтому такую оценку полезно предварительно сравнить с экспертной разметкой на части набора данных. Так команда разработки может понять, в каких задачах автоматический grader достаточно надёжен, а где всё ещё нужен человек. Кодом проверяем то, что можно формализовать. Моделью — неоднозначные критерии. Человеком — спорные или высокорисковые случаи. Если агент ещё проектируется, eval-набор и критерии полезно определить заранее. См. «Как создать ИИ-агента». Здесь важно различать capability и reliability. Capability отвечает на вопрос: способен ли ИИ-агент решить такую задачу? Reliability отвечает на другой вопрос: насколько стабильно AI-система работает при повторных попытках? Поэтому нужно измерять не только долю успехов, но и стабильность поведения агентов, частоту повторов и способность завершать разные задачи в заданных условиях. Два запуска одного ИИ-агента могут привести к разным решениям и траекториям. Один удачный запуск подтверждает capability, но не доказывает reliability. Для production-систем это важное различие: возможность иногда получить правильный ответ не равна стабильной работе. Даже хороший offline eval set не способен заранее воспроизвести весь длинный хвост реальных запросов и рабочих процессов. В production появляются новые сочетания данных, нестабильность API, необычные действия пользователей, аномально долгие или дорогие запуски. Особенно это важно, когда ИИ-агент встроен в бизнес-процессы компании: меняет записи, работает с клиентами, получает данные из корпоративных систем или запускает автоматизацию через API. Поэтому offline evaluation и production monitoring дополняют друг друга. Трассы, аналитика и обратная связь помогают находить новые случаи, а затем добавлять их в набор регрессионных тестов. Регрессионную проверку стоит повторять при изменении модели, prompt, настроек API, логики workflow или других компонентов AI-системы. Так команда может контролировать, не ухудшила ли новая версия уже работавшие сценарии. Не каждую метрику стоит напрямую считать качеством ИИ-агента. Если политика требует подтверждение перед переводом денег, публикацией или удалением данных, участие человека является нормальной частью процесса. Другая ситуация — оператор подключается потому, что AI-система не смогла самостоятельно продолжить работу. Поэтому intervention rate нужно анализировать вместе с причиной эскалации. Подробнее о Human-in-the-Loop, approvals и границах автономности — в материале «Автономность ИИ-агента: сколько свободы давать AI-агенту». Первый ИИ-агент может стоить условно Поэтому иногда полезнее считать Для поддержки клиентов в реальном времени задержка непосредственно влияет на пользовательский опыт. Для фоновой обработки документов те же несколько секунд могут не иметь большого значения. Полезно различать общее время до ответа, время работы модели, задержку API и дополнительное время, которое уходит на retries. Для первой версии не обязательно сразу внедрять сложную платформу оценки. Такая методика позволяет не просто оценить ИИ-агента, а понять, как он работает, почему принимает конкретные решения и насколько его поведение остаётся стабильным при изменении запросов и условий. Смысл оценки ИИ-агентов не в том, чтобы присвоить модели ещё один общий балл. Задача — сделать работу AI-системы проверяемой. Для этого анализируют фактический эффект, решения модели, действия агента, trajectory, восстановление, остановку и стабильность повторных запусков.Почему правильного ответа недостаточно для оценки ИИ-агента
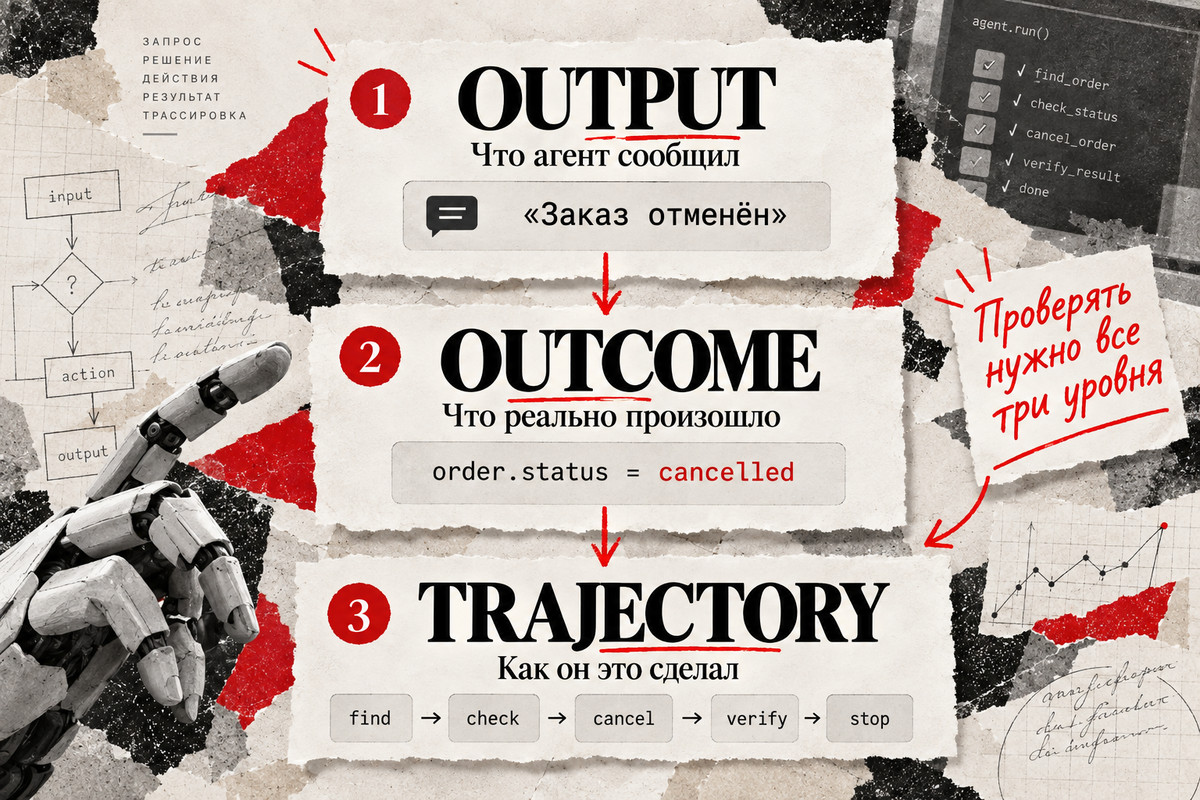
Output, Outcome и Trajectory — три разных объекта оценки
order.status действительно изменился на cancelled, это уже outcome — фактическое изменение данных по итогам работы.find_order
→ check_status
→ cancel_order
→ verify_result
→ stopfind_order
→ wrong_action
→ error
→ retry
→ cancel_order
→ duplicate_action
→ success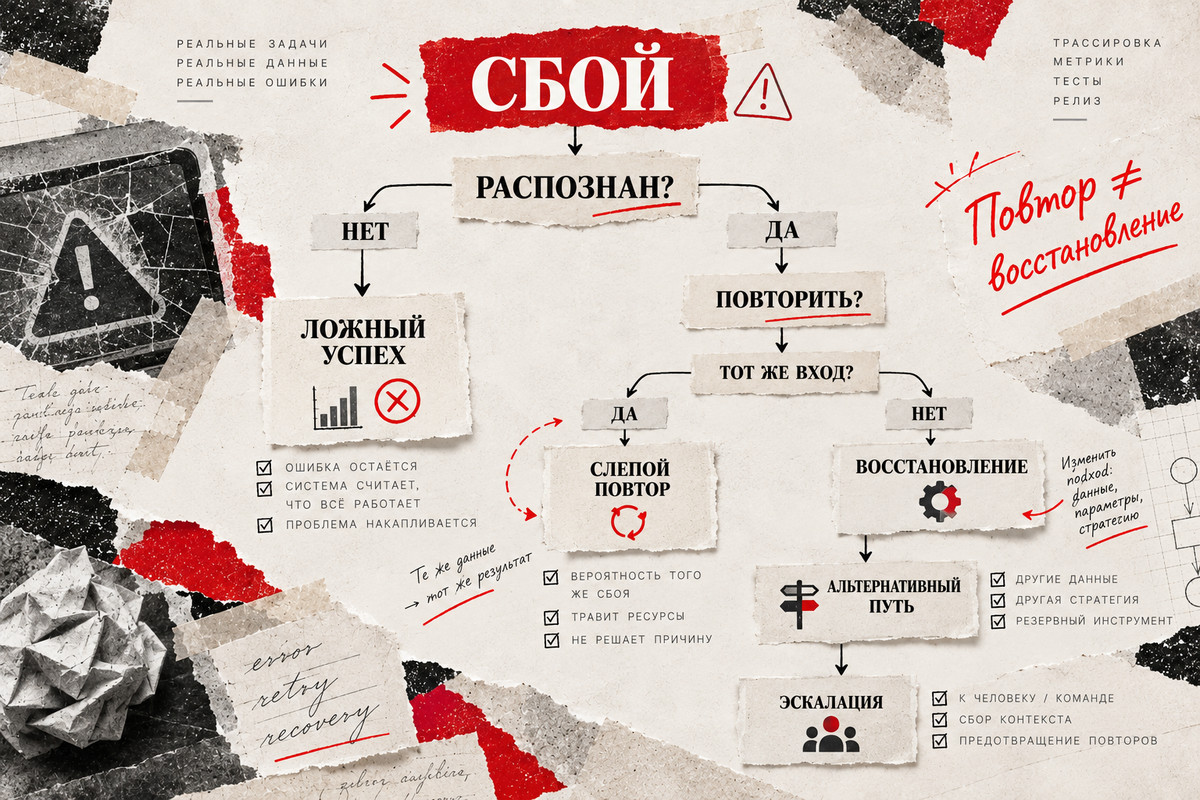
Что именно нужно оценивать у ИИ-агента
Уровень
Что анализируем
Типичная ошибка
Outcome
Достижение цели
Агент сообщил об успехе, но требуемого изменения нет
Tool selection
Выбор подходящего средства
Агент выбрал инструмент, который не соответствует задаче
Параметры
Точность переданных значений
ID, сумма или другой параметр неверны
Операция
Технический статус обращения
Timeout или отказ API
Использование ответа
Интерпретация полученных данных
Данные проигнорированы или поняты неверно
Контекст
Актуальность информации между шагами
Использованы устаревшие данные
Trajectory
Допустимость пути к цели
Лишние или нарушающие порядок действия
Recovery
Реакция на отказ
Повтор одной стратегии без изменений
Завершение
Своевременность остановки
Ранняя остановка или цикл
Участие человека
Подтверждение и эскалация
Обязательный approval пропущен
Operations
Стоимость и время
Слишком дорогой или медленный процесс
Reliability
Стабильность поведения
Успех достигается только в части запусков
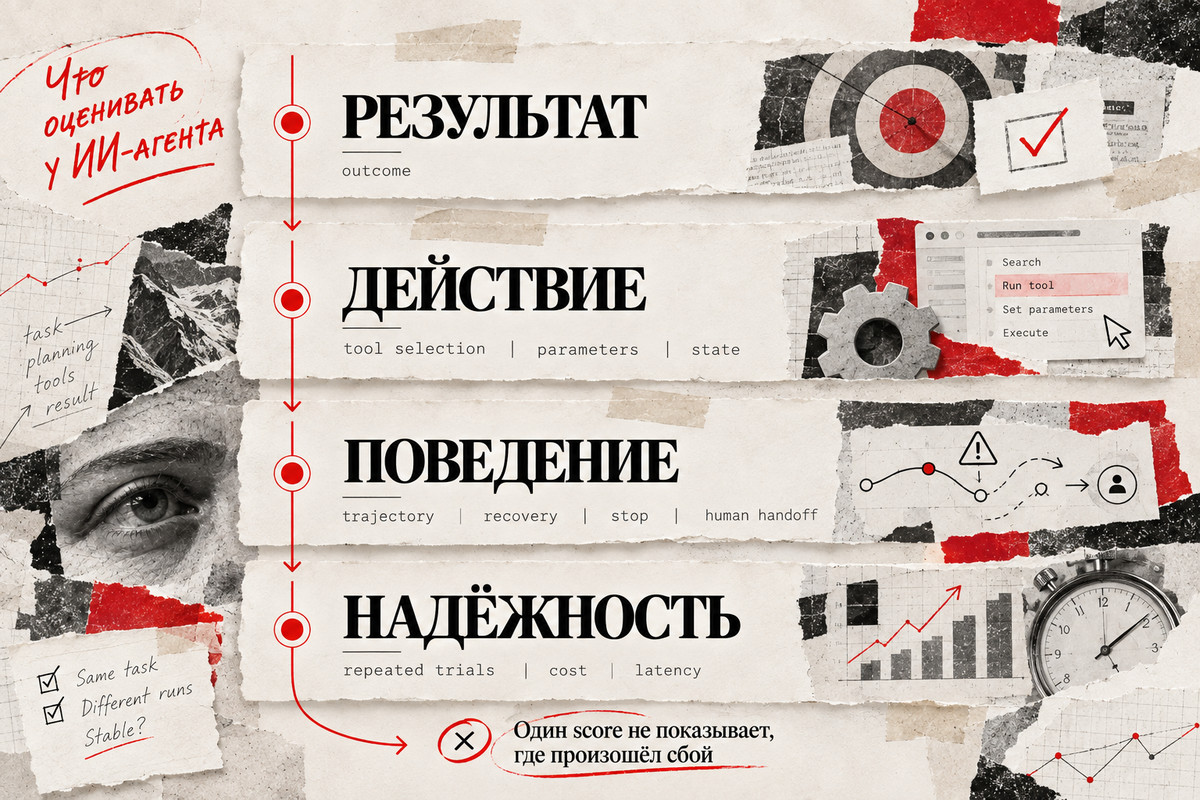
Outcome-first, но не outcome-only
Минимум, с которого можно начать
Почему одного общего score недостаточно
Agent Quality: 82 / 100Как трассировка помогает увидеть, что произошло внутри выполнения
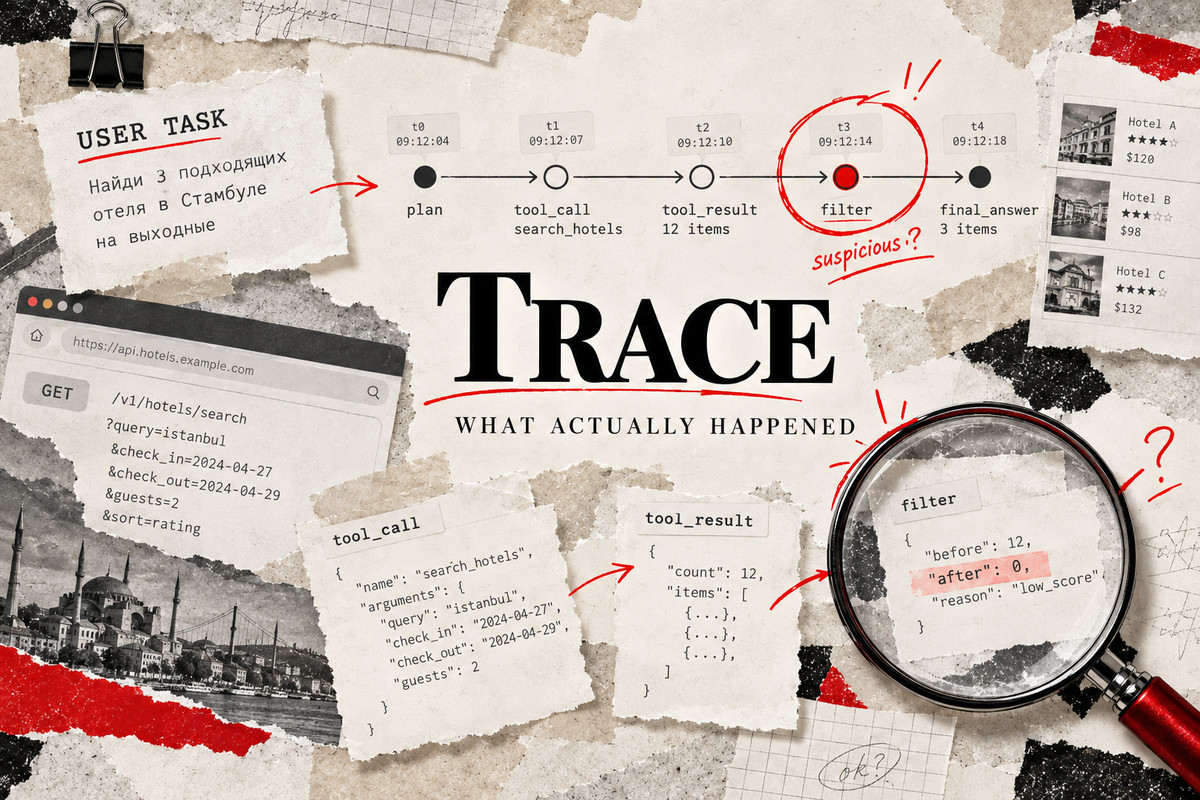
USER TASK
↓
AGENT STEP
↓
TOOL CALL
↓
TOOL RESULT
↓
STATE / OBSERVATION
↓
NEXT ACTION
↓
RETRY / RECOVERY
↓
STOP
↓
OUTCOMETracing, logging, observability и evaluation — не одно и то же
Понятие
Что показывает
Logging
Отдельные события
Tracing
Связь шагов одного запуска
Metrics
Агрегированные показатели
Observability
Поведение системы в целом
Evaluation
Соответствие заданным критериям
Tool A
→ Tool B
→ Tool A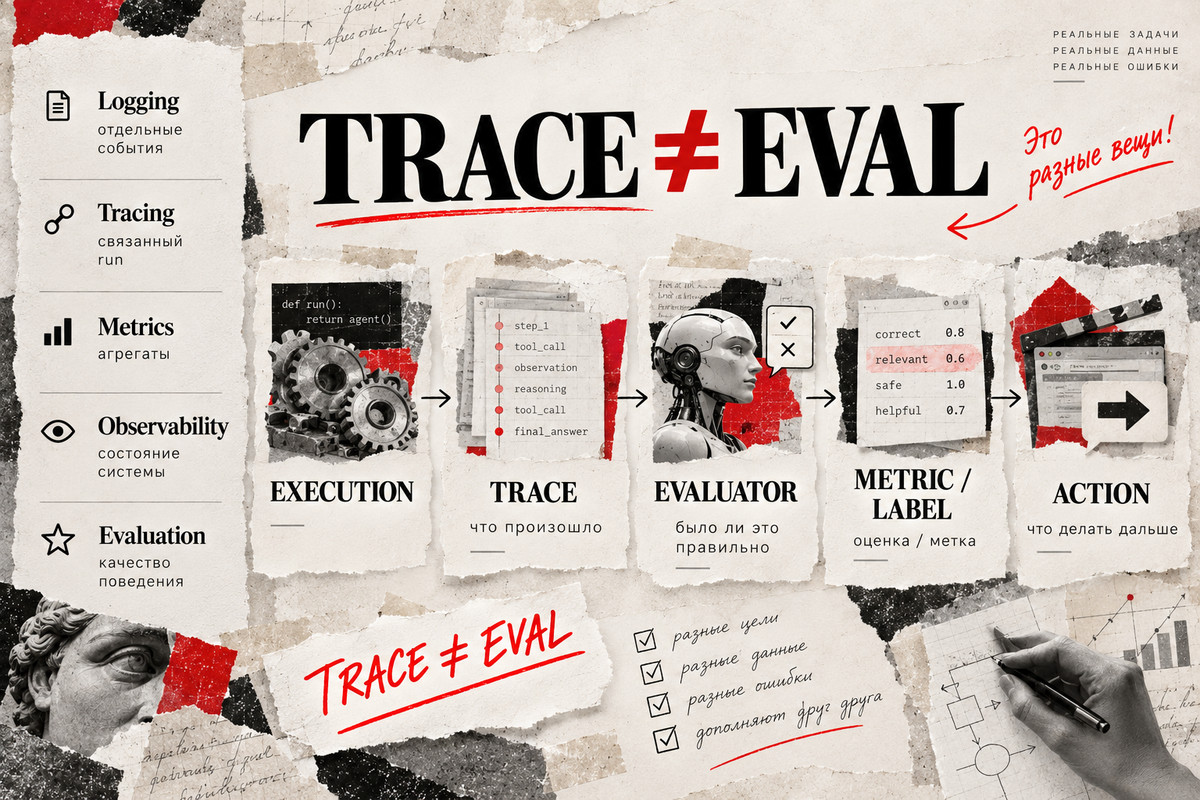
Как по trace найти место, где агент ошибся
Сначала проверить outcome
Затем проверить выбор инструмента и параметры
подходящая функция выбрана
↓
параметры проходят schema validation
↓
значения соответствуют запросу
↓
операция завершена
↓
ответ использован в следующем решенииcancel_order(order_id="1027")1072, действие всё равно неверно.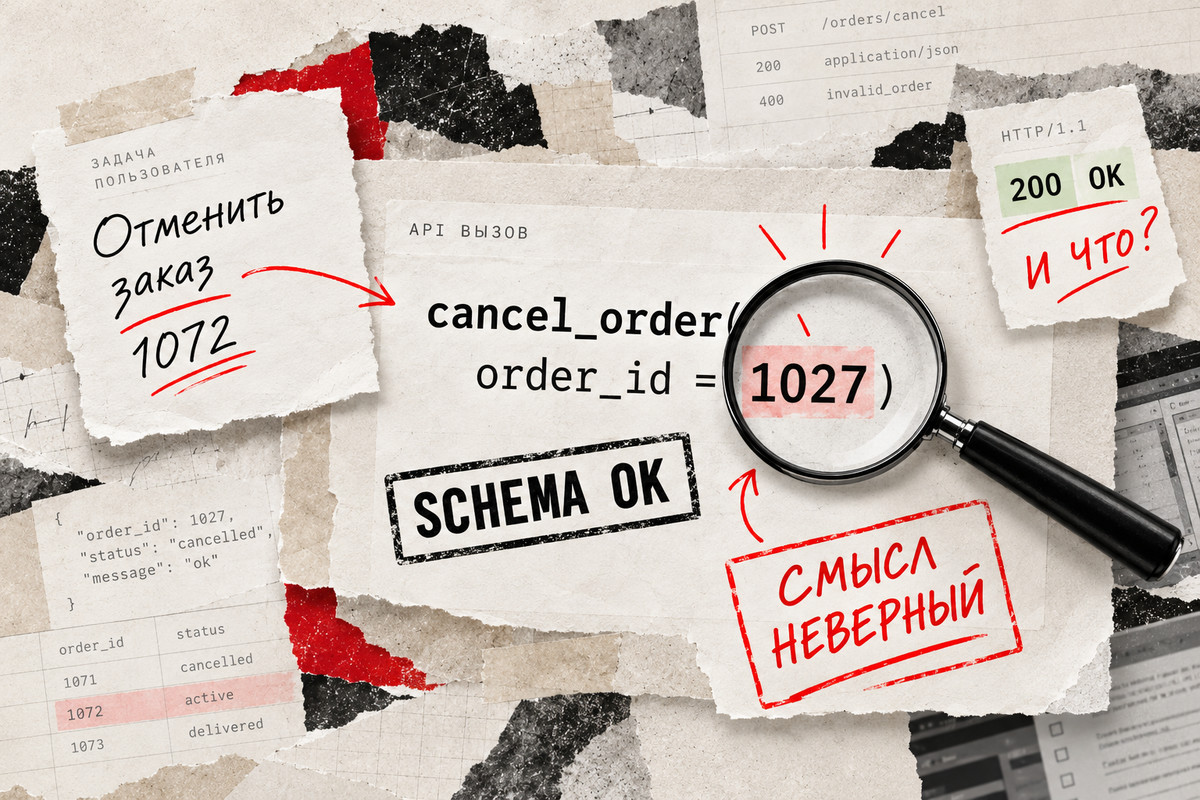
Затем проверить trajectory и контекст
Проверить восстановление при отказе
FAILURE
↓
AGENT RECOGNIZED IT?
↓
RETRY?
↓
CHANGED ARGUMENTS?
↓
ALTERNATIVE PATH?
↓
FALLBACK?
↓
ESCALATION?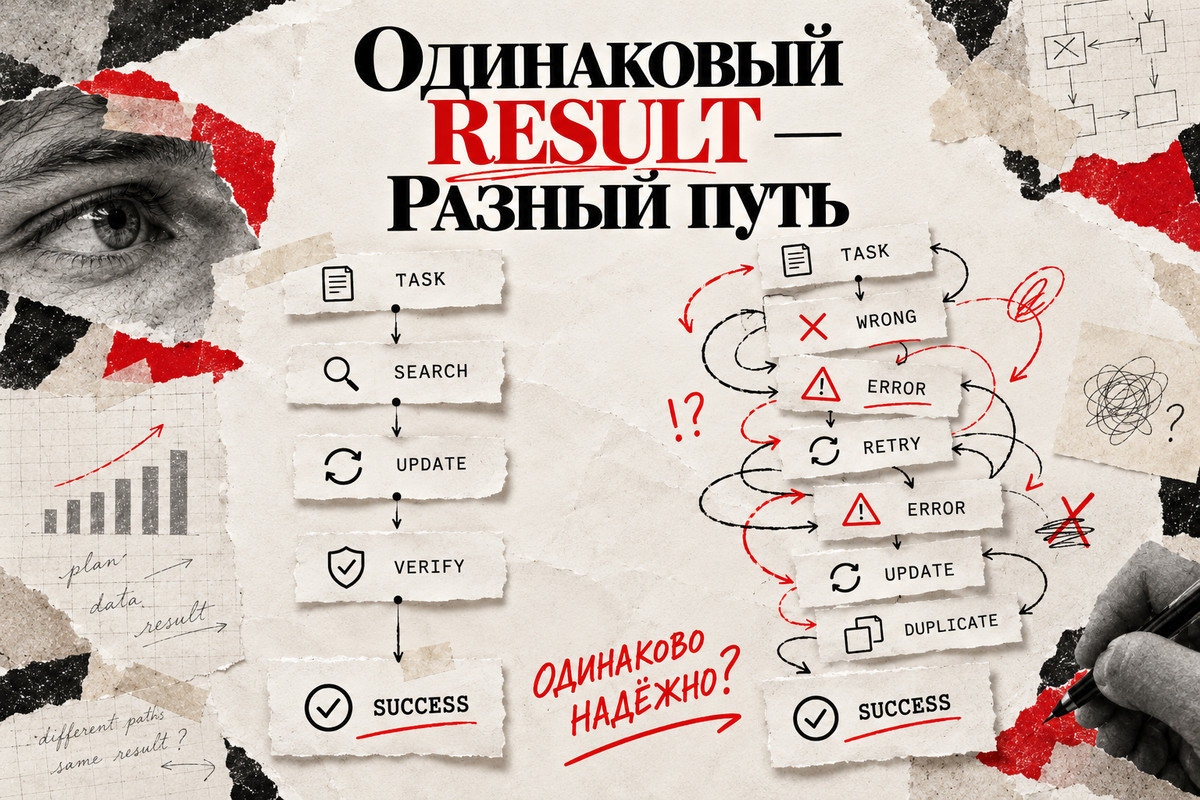
Проверить завершение задачи
Почему одной эталонной траектории часто недостаточно
verify_identity
→ request_approval
→ process_refund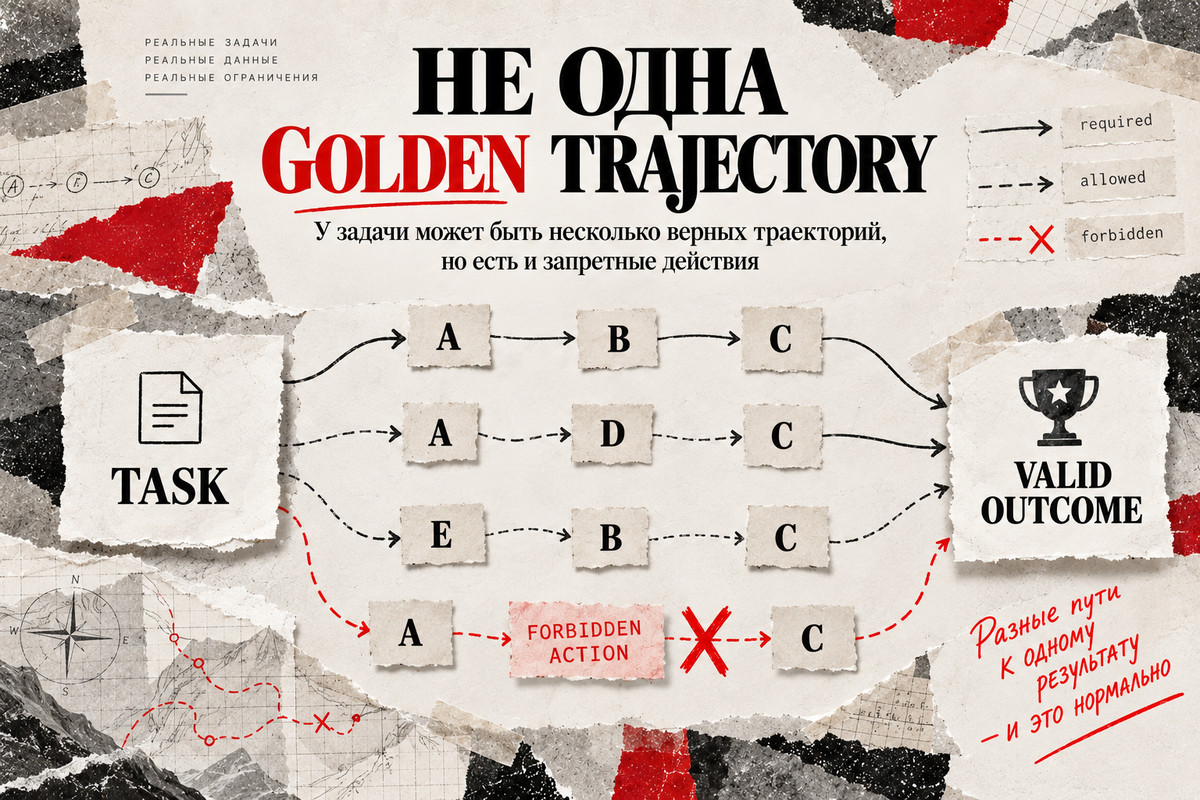
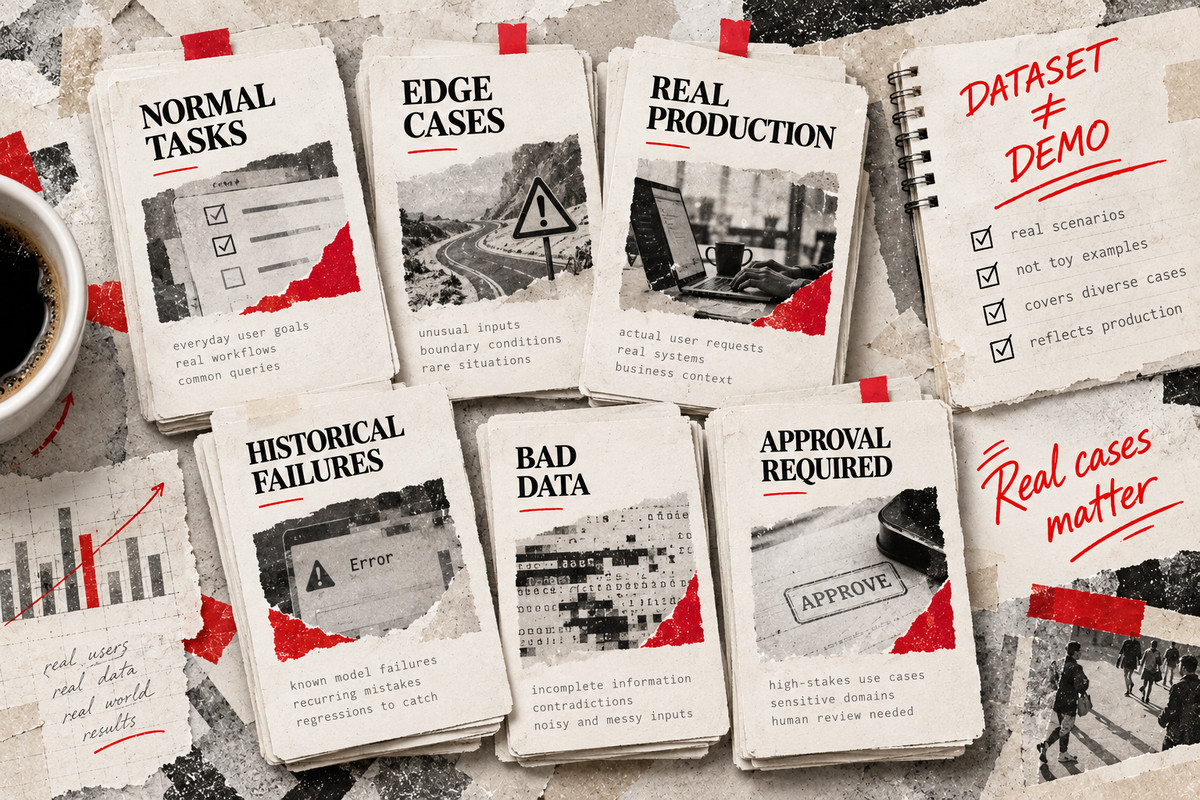
Как построить eval-набор до запуска агента
Каким evaluator проверять разные требования
Что проверяется
Подход
JSON / schema
Код или программное правило
Запись существует в базе данных
Проверка данных
Нужная функция использована
Rule-based check
Соблюдена политика approval
Invariant / rule
Качество ответа модели
Model-based grader
Открытая сложная задача
Rubric + model/human review
Высокорисковая операция
Экспертная проверка
LLM-as-Judge полезен, но не является ground truth
Один успешный запуск ещё не означает надёжность
pass@k показывает, был ли хотя бы один успешный запуск среди k попыток.pass^k показывает, успешны ли все k попыток.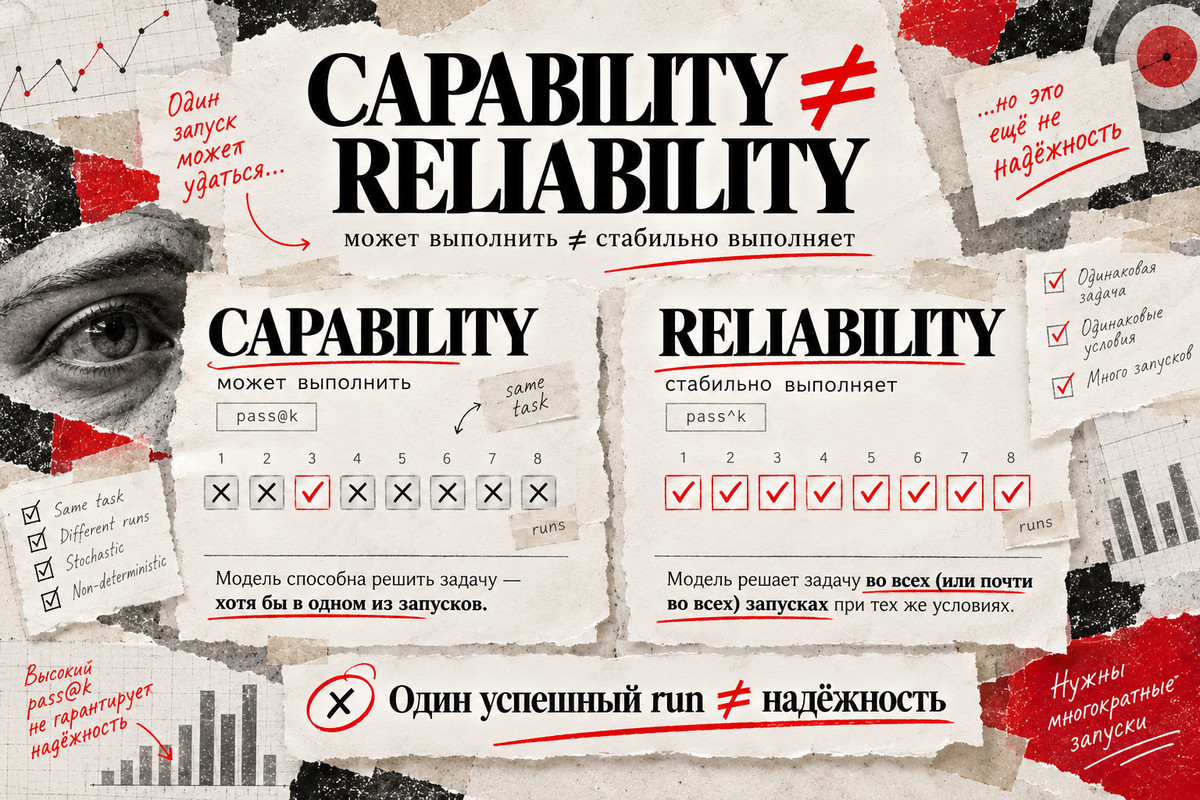
Что меняется после выхода агента в production
PRODUCTION TRACE
↓
FAILURE SIGNAL
↓
FAILURE CLUSTER
↓
REPRODUCIBLE TEST CASE
↓
OFFLINE REGRESSION
↓
FIX
↓
VERIFY
↓
RELEASE
↓
PRODUCTION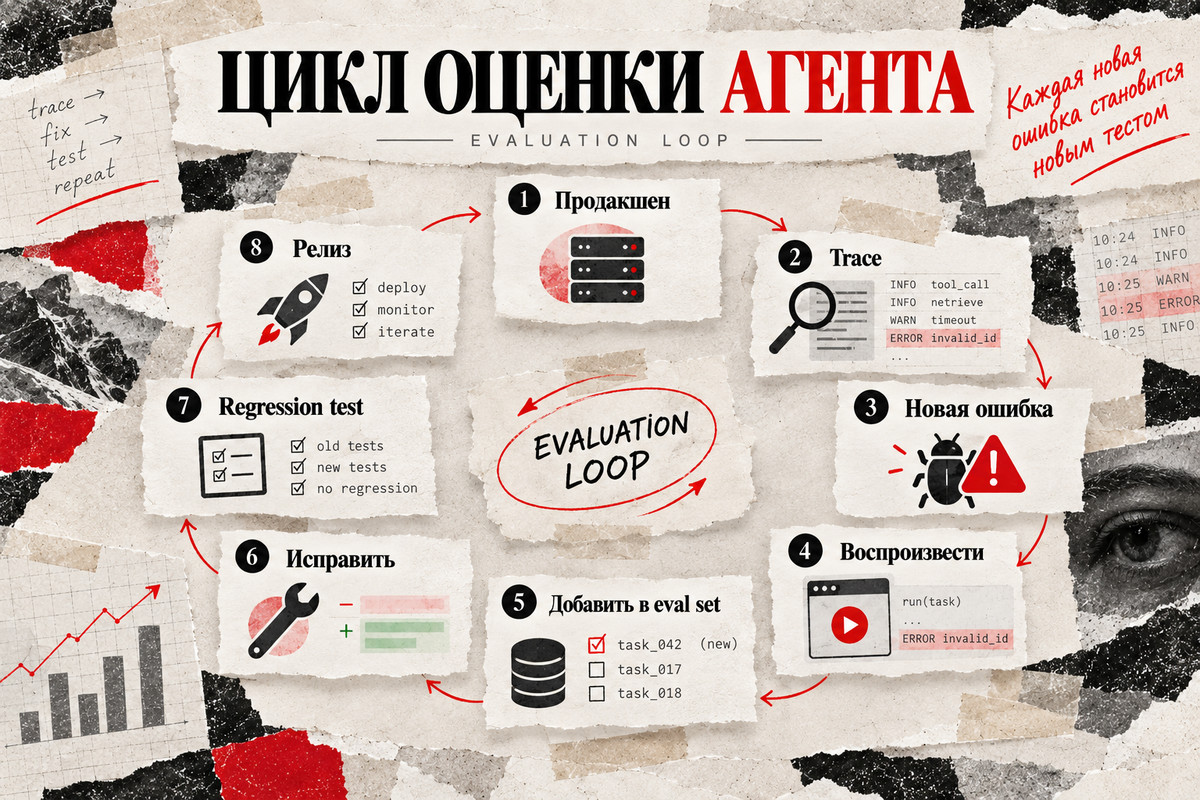
Как интерпретировать участие человека, стоимость и latency
Не всякое вмешательство человека — ошибка
Низкая стоимость не означает лучшего агента
$0.05 за попытку и решать только половину задач. Второй стоит $0.08, но работает значительно стабильнее.cost per successful task, а не только цену одного запуска.Latency зависит от пользовательского сценария
Минимальная система оценки ИИ-агента на практике
Вывод
Источники и документация
pass^k для оценки стабильности поведения агента между повторными trials.
Оценка ИИ-агентов: как проверять многошаговую работу и находить ошибки
«Заказ отменён».
Главное различие
Outcome-first, но не outcome-only.
Trace показывает, что произошло. Evaluator определяет, соответствует ли это критериям.
Практический принцип
Надёжной можно считать систему, у которой команда способна воспроизвести неудачный сценарий, определить его причину и проверить, что изменения действительно улучшили работу агента.