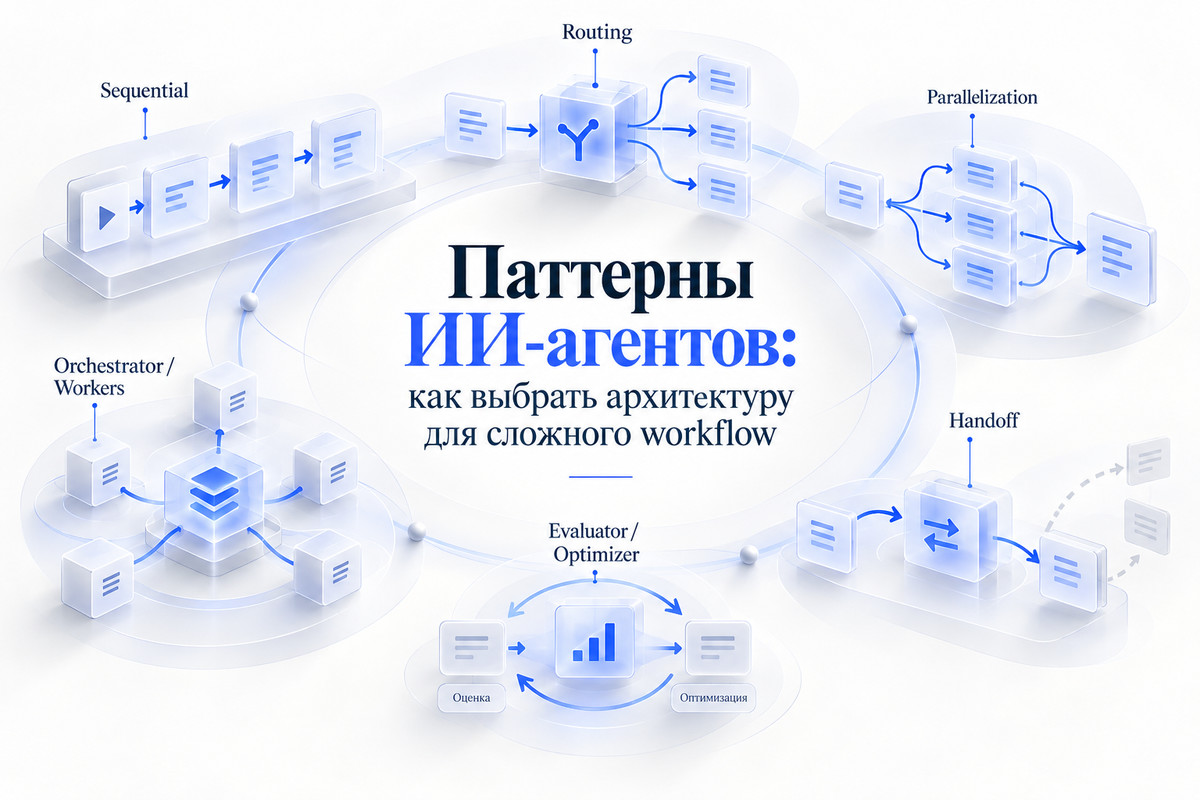
Паттерны ИИ-агентов — это повторяющиеся способы организовать сложный workflow: связать зависимые этапы в цепочку, направить запрос по подходящему маршруту, запустить несколько частей процесса параллельно, динамически распределить работу, добавить цикл проверки или передать управление другому агенту. Выбор зависит от структуры процесса, необходимой гибкости, задержки, стоимости и того, насколько предсказуемым должен оставаться ход выполнения.
При проектировании агентной системы полезно сначала определить основную логику процесса, а уже затем добавлять дополнительные механизмы контроля.
| Если процесс устроен так | Базовый выбор |
|---|---|
| порядок зависимых этапов фиксирован до запуска | Последовательный workflow / Prompt Chaining |
| требуется выбрать один из предусмотренных маршрутов | Маршрутизация (Routing) |
| несколько частей можно выполнить без ожидания друг друга | Параллельное выполнение (Parallelization) |
| необходимый состав работ определяется по ходу процесса | Оркестратор и workers (Orchestrator–Workers) |
После выбора базовой схемы стоит отдельно проверить ещё два требования:
| Дополнительная потребность | Механизм |
|---|---|
| ответ нужно итеративно улучшать по проверяемым критериям | Evaluator–Optimizer |
| другой специалист должен принять дальнейшее управление | Handoff |
Цикл оценки и передача управления не обязательно конкурируют с первыми четырьмя паттернами. Они могут дополнять уже выбранную схему.
Использовать самый простой control flow, который даёт процессу необходимую гибкость.
Что такое паттерны ИИ-агентов и зачем они нужны
Архитектура ИИ-агента описывает систему целиком: где находится языковая модель, какой код управляет процессом, какие инструменты доступны агенту, какие данные и контекст он получает, какие операции разрешены и где хранится состояние.
Паттерн решает более узкую проблему. Он описывает повторяющуюся форму организации одной части агентной системы — прежде всего того, как работа переходит между этапами и кто определяет следующий шаг.
Architecture ≠ Pattern.
ИИ-агент работает не в вакууме. На каждом шаге агент получает определённый вход, инструкции, доступный контекст и набор разрешённых операций. Паттерн определяет, откуда приходит этот вход, кто решает, что агент должен делать дальше, и куда передаётся полученный ответ.
INPUT
  ↓
ROUTING
  ↓
ORCHESTRATOR
  ↓
PARALLEL WORKERS
  ↓
AGGREGATION
  ↓
EVALUATOR
  ↓
RESULT
Сначала выбирается подходящий маршрут. Затем управляющий компонент разбивает запрос на части. Несколько специализированных ролей выполняют свою часть процесса, после чего выводы объединяются и проходят проверку.
Все эти механизмы могут существовать внутри одной агентной системы.
Pattern ≠ Framework.
Prompt Chaining, маршрутизацию или передачу управления можно реализовать на разных технологических стеках. Framework предоставляет API, готовые компоненты и runtime-механизмы, но сама логика процесса от конкретной библиотеки не зависит.
Паттерн не означает, что системе обязательно нужны несколько агентов
Сложный agentic workflow часто автоматически представляют как группу автономных ИИ-агентов. Это необязательное условие.
Один агент может последовательно выполнять несколько ролей, работать с разными инструкциями и обращаться к разным инструментам. Последовательная цепочка способна несколько раз использовать одну LLM. Маршрутизатор может выбирать между prompts, моделями, инструментами или сценариями автоматизации. Параллельная схема тоже может состоять из нескольких одновременных вызовов одной модели.
Даже worker в Orchestrator–Workers не обязан быть полноценным самостоятельным агентом. Это может быть специализированный LLM-вызов, ограниченная роль, программный компонент или обработчик с доступом к конкретному набору инструментов.
Complex workflow ≠ обязательно Multi-Agent.
В этой статье нас интересует прежде всего логика движения работы через систему. Вопрос о том, когда один агент действительно стоит разделять на несколько специализированных агентов, относится к отдельной архитектурной теме.
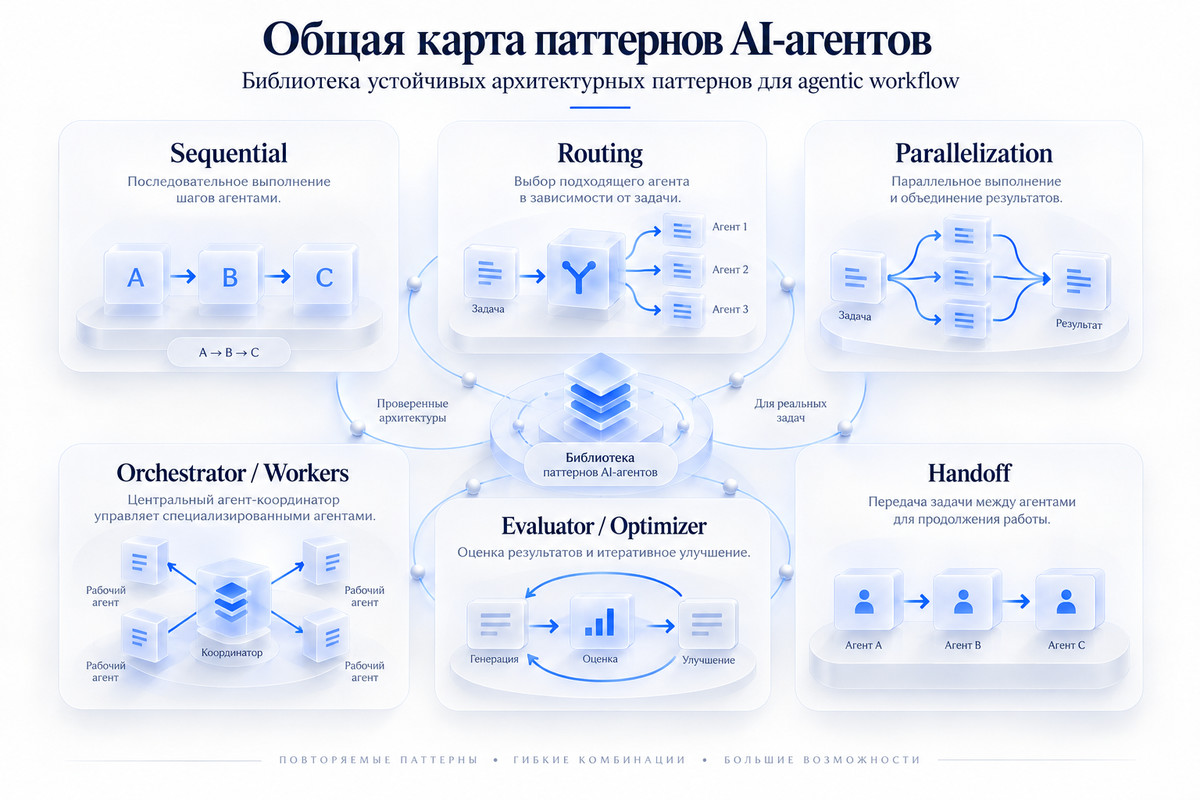
Как выбрать архитектуру: кто должен управлять следующим шагом
Кто решает, что агент должен делать дальше — код приложения или сама модель?
На одном конце спектра находится детерминированный процесс. Разработчик задаёт этапы, переходы, проверки и условия остановки. LLM выполняет интеллектуальную часть внутри отдельных стадий, но не управляет всей последовательностью.
На другом конце — model-driven orchestration. Здесь агент получает текущий контекст и сам определяет следующий шаг: выбрать специалиста, сформировать новую часть работы, вызвать инструмент или продолжить по другому пути.
Между этими полюсами существует множество промежуточных вариантов.
Например, маршрутизацию можно полностью описать кодом, а LLM подключать только к неоднозначным запросам. Или модель динамически определяет состав работ, но каждая специализированная роль действует в строго ограниченных рамках.
Если маршрут можно надёжно зафиксировать до запуска, его обычно нет смысла отдавать LLM. Если агент должен сам выбирать следующий шаг на основе информации, которая появляется только по ходу процесса, model-driven orchestration начинает оправдывать дополнительную сложность.
Оркестрация ИИ-агентов в широком смысле отвечает за управление процессом: кто принимает решение, как распределяется работа, что можно запускать одновременно и кто собирает итог.
Но дополнительная динамичность имеет цену.
Чем больше решений принимает сама модель, тем сложнее заранее оценить:
- точную последовательность этапов;
- количество обращений к LLM;
- объём контекста;
- расход токенов;
- скорость;
- итоговую стоимость;
- число возможных сценариев отказа.
Поэтому динамическое управление полезно не само по себе. Оно должно закрывать реальную неопределённость, которую трудно надёжно выразить обычной логикой приложения.
Комментарий Анастасии Чернецкой
«Я бы не отдавала модели выбор следующего шага только потому, что технически это возможно. Если маршрут уже понятен и его можно надёжно описать правилами или кодом, такой workflow обычно проще контролировать, тестировать и поддерживать. Динамическое решение со стороны LLM имеет смысл там, где следующий шаг действительно зависит от контекста, который появляется только во время выполнения. Иначе мы добавляем вариативность в место, где она ничего полезного не даёт».
Последовательный workflow (Prompt Chaining)
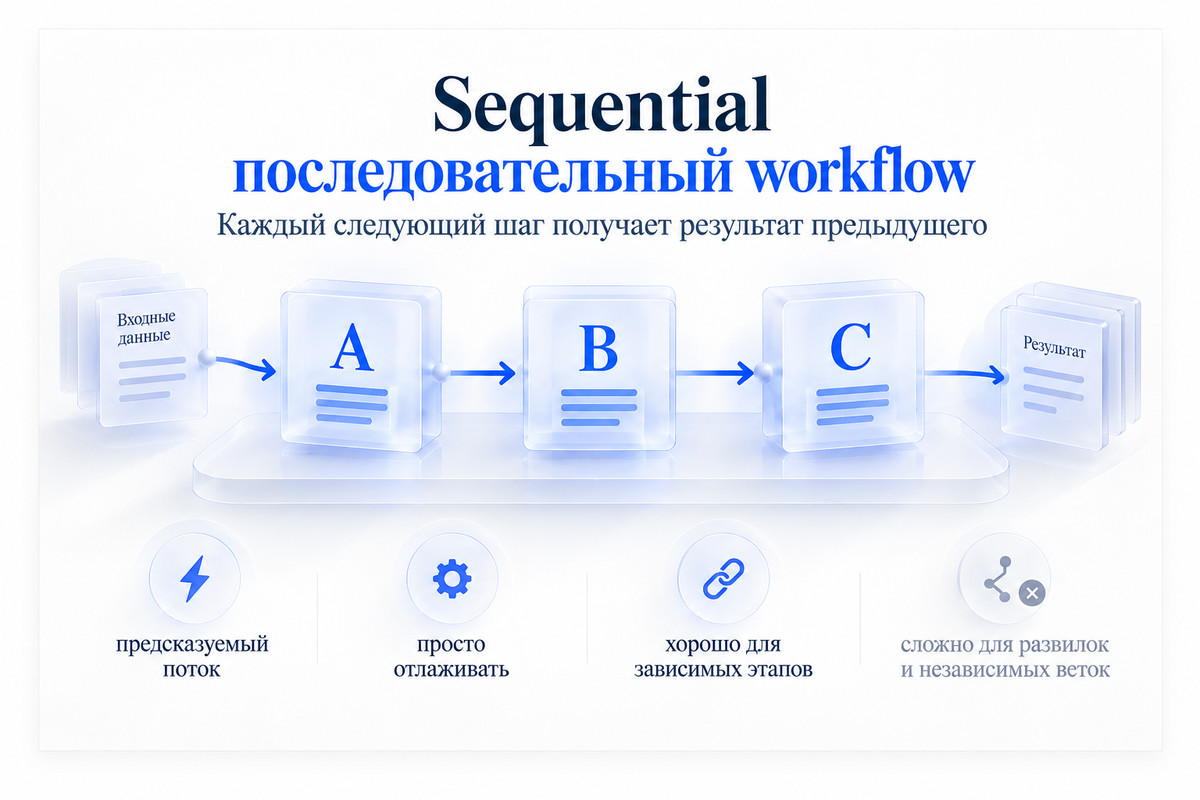
Если следующий этап нельзя корректно начать без ответа предыдущего, естественной схемой становится последовательная цепочка.
A → B → C
Например:
исследование
→ структура
→ черновик
→ редактура
Или:
extract
→ classify
→ transform
→ validate
Здесь порядок задаётся кодом или workflow engine. Агент не выбирает произвольный маршрут: каждый вызов модели решает ограниченную часть общего процесса.
Когда подходит последовательная цепочка
Prompt Chaining полезен, если процесс можно разделить на зависимые стадии, а output одного этапа становится входом следующего.
Особенно устойчивой такая схема становится при понятном контракте между стадиями:
STEP A
↓
STRUCTURED OUTPUT
↓
VALIDATION
↓
STEP B
Например, первая модель извлекает из документов названия компаний, даты и источники. Следующая стадия ожидает именно эти структурированные данные.
Вместо свободного текста лучше передавать объект с обязательными полями. Код может проверить формат, наличие критичной информации и только после этого продолжить процесс.
Чем сильнее следующий этап зависит от предыдущего, тем важнее определить:
- какой вход нужен;
- какие поля обязательны;
- какие ограничения проверяются;
- при каких условиях цепочка останавливается.
Такой контракт упрощает контроль и диагностику.
Задержка, стоимость и контроль
Главный компромисс последовательной схемы — скорость.
Если каждый этап ждёт предыдущий:
A + B + C
общее время постепенно складывается.
Количество обращений к модели обычно фиксировано структурой процесса, поэтому такую систему проще оценивать, чем динамическую.
При этом одинаковая topology не означает одинаковую стоимость запуска. Размер документов, объём контекста, длина ответа, использование инструментов и число токенов могут различаться.
Главное преимущество Prompt Chaining — предсказуемая логика процесса, а не гарантированно фиксированная цена.
Типичный сбой: error propagation
Основной риск — распространение ошибки дальше по цепочке.
A вернул корректный JSON
↓
но пропустил важную сущность
↓
B успешно обработал неполные данные
↓
C сформировал логичный, но неверный итог
Поэтому validation gate проверяет не только schema, но и содержательные условия.
Можно ли технически использовать полученные данные дальше?
Хватает ли их для следующего шага?
Когда не использовать
Если несколько частей процесса не зависят друг от друга, последовательная обработка создаёт лишнюю задержку.
Технический анализ, юридическую проверку и исследование рынка, например, можно проводить одновременно. Для такой структуры естественнее параллельная схема.
Маршрутизация (Routing): выбрать один из предусмотренных путей
Иногда системе не требуется придумывать новые этапы. Сначала нужно понять, к какому типу относится входящий запрос.
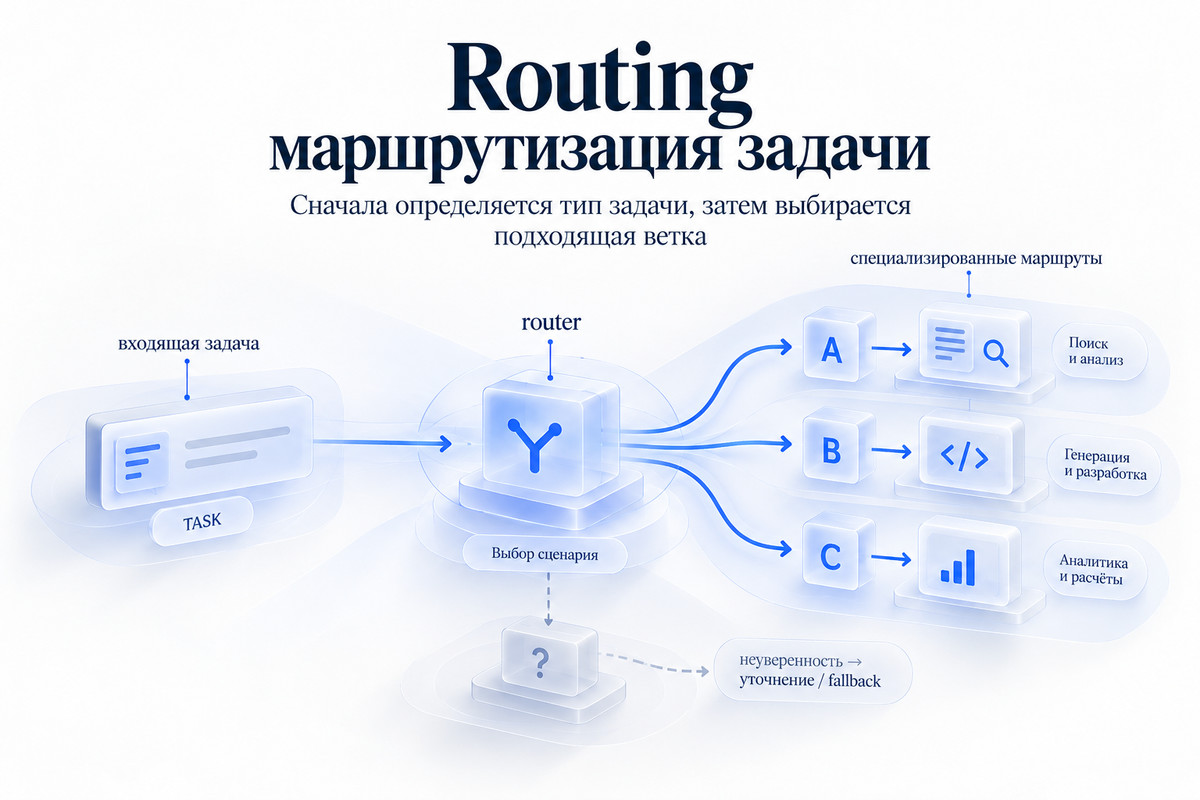
Маршрутизация используется, когда набор возможных сценариев задан до запуска, а текущий вход необходимо направить по подходящему пути.
            ┌→ A
INPUT → ROUTER → B
            └→ C
Например:
оплата
техническая поддержка
возврат
Каждому варианту могут соответствовать свои инструкции, инструменты, код обработки, модель или специализированный агент.
Набор маршрутов фиксирован, а решение принимается для конкретного входа.
Маршрутизатор не обязательно является LLM
Если путь легко определяется условием в коде, использовать ИИ нет необходимости.
Когда категория уже присутствует в структурированных данных, повторно угадывать её по тексту не нужно.
В других случаях применяется классификатор. Если запрос требует смыслового понимания, маршрутизацию может выполнять LLM.
Практична гибридная логика:
очевидный случай
→ правило в коде

неоднозначный случай
→ classifier / LLM
Так простые решения остаются детерминированными, а интеллект модели используется там, где он действительно нужен.
Маршрутизация может применяться и для model selection: простой вход направляется более дешёвой модели, сложный — более сильной.
Что делать, если система не уверена в маршруте
Не каждый запрос удаётся надёжно классифицировать.
Поэтому полезен fallback:
high confidence
→ нужный маршрут

low confidence
→ уточнение / общий обработчик / fallback
Если агент вынужден выбирать специалиста при низкой уверенности, неопределённость превращается в misrouting.
Иногда лучший следующий шаг — запросить у пользователя дополнительные данные и только после этого определить путь.
Типичный сбой: misrouting
Ошибочная маршрутизация опасна тем, что выбранная ветвь может работать безупречно, но решать чужую проблему.
Запрос по оплате, например, попадает в технический сценарий. Ответ специалиста может быть качественным, однако пользователь не получит нужной помощи.
Поэтому надёжность определяется не только качеством модели или обработчика, но и логикой выбора:
Кому передать этот запрос?
Особенно сложны входы с несколькими интентами и частично пересекающиеся категории.
Routing ≠ Handoff
Routing определяет подходящий путь обработки.
Handoff передаёт активное управление другому агенту.
Выбор маршрута и смена владельца взаимодействия — разные архитектурные операции.
Когда Routing не нужен
Если набор требуемых работ нельзя разумно перечислить до начала процесса и состав следующих шагов зависит от конкретного контекста, простого выбора маршрута уже недостаточно.
Здесь нужна динамическая декомпозиция.
Параллельное выполнение (Parallelization): когда части процесса не зависят друг от друга
Один из самых простых способов повысить скорость — не выполнять последовательно то, что можно обработать одновременно.
       ┌→ A ─┐
TASK ──┼→ B ─┼→ AGGREGATE
       └→ C ─┘
При Parallelization несколько частей запускаются одновременно.
Sectioning: разные части одного запроса
Большой объём можно разделить по направлениям:
юридический анализ
технический анализ
анализ рынка
После завершения выводы объединяются.
Ключевое условие: каждой ветви хватает собственного входа и контекста, а для начала её работы не требуется ответ соседней ветви.
Multiple attempts и voting
Другой вариант — запустить несколько попыток решить одну проблему.
Например, несколько проверяющих вызовов независимо анализируют ответ на наличие ошибок, после чего система объединяет найденные сигналы.
Здесь параллельность используется не для разделения объёма, а для нескольких независимых оценок.
Параллельная схема уменьшает время ожидания, но не обязательно стоимость
Упрощённо:
Sequential:
A + B + C

Parallel:
max(A, B, C) + Aggregate
Три одновременных обращения к модели всё равно остаются тремя обращениями.
Такой подход может уменьшить wall-clock latency, но не уменьшает автоматически объём контекста, token usage, вычислительную нагрузку или стоимость последующей сборки.
Быстрее ≠ дешевле.
Fan-out — только половина схемы
Запустить несколько ветвей недостаточно.
После fan-out требуется fan-in — момент, когда частичные ответы снова превращаются в единый итог или основание для следующего шага.
FAN-OUT
↓
A  B  C
↓
FAN-IN
↓
AGGREGATE
Здесь важно заранее определить:
- нужны ли ответы всех ветвей;
- допустим ли partial result;
- сколько ждать медленную часть;
- что происходит при timeout;
- как обработать сбой одной ветви;
- как свести противоречивые выводы.
Поэтому aggregation — часть архитектуры, а не формальность после параллельного запуска.
Типичные сбои
Straggler — одна медленная ветвь задерживает общий итог.
Conflict — параллельные части возвращают несовместимые выводы.
Aggregation failure — отдельные ответы корректны, но система неверно собирает их вместе.
Дополнительный риск появляется при общем изменяемом состоянии. Если две операции одновременно меняют один объект или внешний ресурс, они уже не могут считаться полностью автономными.
Параллелить безопаснее то, что не требует ответа друг друга и не создаёт конфликтующих side effects.
Когда не использовать
Если B требует output A, а C — output B, последовательная схема естественнее.
Параллельный запуск также не отвечает на вопрос:
Какие части вообще необходимо создать для данного входа?
Если это становится понятно только по ходу анализа, сначала нужен управляющий слой.
Оркестратор и workers (Orchestrator–Workers)
Иногда до запуска невозможно перечислить весь будущий путь.
Общая цель понятна, но состав необходимых работ определяется только после анализа входных данных, текущего контекста и состояния проекта.
              ┌→ WORKER 1
TASK → ORCHESTRATOR → WORKER 2
              └→ WORKER 3
                     ↓
                 SYNTHESIS
Оркестратор ИИ-агентов анализирует запрос, выполняет декомпозицию, распределяет отдельные части и затем собирает полученные outputs.
Что делает управляющий компонент
- определить, что именно нужно сделать;
- выбрать подходящие роли или компоненты;
- распределить отдельные части;
- собрать частичные ответы в итог.
Например, при изменении программного проекта после анализа может выясниться, что требуется:
изменить API
обновить 4 файла
добавить тест
проверить документацию
Для другого запроса набор будет другим.
В этом и состоит отличие динамической оркестрации от fixed workflow, где структура процесса уже описана кодом.
Worker не обязательно является автономным агентом
Worker — это роль или компонент, которому делегирована ограниченная часть работы.
Им может быть:
- отдельный специализированный агент;
- ограниченный вызов LLM;
- программный обработчик;
- компонент с собственными инструкциями;
- tool-backed role.
Поэтому наличие нескольких workers ещё не превращает систему автоматически в сложную multi-agent architecture.
Orchestrator ≠ Router
Router выбирает один путь из заданного набора.
Orchestrator определяет, что вообще потребуется сделать для текущего входа.
Routing = classification.
Orchestrator = decomposition + delegation + synthesis.
Orchestrator–Workers ≠ Parallelization
В Parallelization состав параллельных частей уже задан.
В Orchestrator–Workers он формируется динамически.
TASK
↓
ORCHESTRATOR
↓
dynamic decomposition
↓
┌→ Worker A ─┐
├→ Worker B ─┼→ SYNTHESIS
└→ Worker C ─┘
Parallelization отвечает на вопрос «как одновременно выполнить уже определённые части?».
Orchestrator–Workers — «кто определит, что именно необходимо сделать для текущего входа?».
Нужен контракт делегирования
Передача части процесса работает устойчивее, если специализированная роль получает не расплывчатое «разберись с этим», а минимальный task contract:
цель
границы
необходимые данные
ожидаемый output
Это снижает риск пересечения ответственности и упрощает сбор частичных ответов.
Если инструкции сформулированы плохо, отдельные роли могут:
- повторять одно и то же;
- по-разному интерпретировать цель;
- возвращать несовместимые форматы;
- пропускать критичные требования.
Качество делегирования зависит не только от возможностей LLM, но и от ясности постановки.
Нужны границы fan-out
Динамическая декомпозиция не должна означать бесконечное создание новых частей процесса.
Полезно задавать ограничения:
- максимальное число workers;
- бюджет обращений к модели;
- допустимое время;
- глубину делегирования;
- условия остановки.
Такой budget ограничивает не только расход ресурсов, но и последствия плохого решения управляющего агента.
Если один неверный шаг способен породить десятки дополнительных вызовов, локальная ошибка быстро превращается в рост стоимости и задержки.
Coverage before synthesis
Перед финальной сборкой важно проверить не только качество частичных outputs, но и полноту покрытия исходного запроса.
Если одна обязательная часть вообще не была выделена, synthesis не сможет восстановить отсутствующие данные.
Сильные workers не гарантируют полный ответ, если декомпозиция была неполной.
Управляющий контур должен понимать, какие требования уже закрыты, а какие ещё остались.
Задержка и стоимость
Количество вызовов здесь меняется от запуска к запуску.
Поэтому сложнее заранее оценить:
- число обращений к LLM;
- token usage;
- объём передаваемого контекста;
- время;
- итоговые вычислительные затраты.
К обработке отдельных частей добавляются анализ входа, распределение и synthesis.
Параллельность может повысить скорость, но не отменяет дополнительную вычислительную работу.
Типичные failure modes
- bad decomposition;
- missing part;
- overlapping work;
- worker explosion;
- conflicting outputs;
- synthesis loss.
Особенность этого паттерна в том, что ошибка способна возникнуть до фактического исполнения.
Если управляющая логика неверно поняла запрос и плохо разложила работу, сильные модели и качественные инструменты будут хорошо решать неправильно поставленные части.
Когда не использовать
Если структура процесса почти не меняется между запусками, динамическая декомпозиция избыточна.
Если система каждый раз заново приходит к одному и тому же:
A
B
C
эти этапы проще зафиксировать кодом.
Глубокая инженерия orchestration layer — registry, scheduling, durable execution, retries, distributed state и observability — выходит за границы этой статьи.
Оценка и улучшение (Evaluator–Optimizer)
Иногда неопределённость связана не со следующим шагом, а с качеством уже полученного ответа.
Если первый вариант редко удовлетворяет требованиям, но качество можно проверять по понятным критериям, подходит Evaluator–Optimizer.
GENERATE
   ↓
EVALUATE
   ↓
FAIL → IMPROVE → EVALUATE
   ↓
PASS
   ↓
RESULT
Смысл паттерна — управляемый feedback loop.
Когда цикл действительно работает
Проверка полезна, когда критерии можно выразить наблюдаемым образом:
missing required field
failed test
unsupported claim
constraint violation
Такой feedback значительно полезнее, чем «сделай ответ лучше».
В первом случае понятно, какое требование нарушено. Во втором LLM сама интерпретирует расплывчатое понятие качества.
Поэтому хороший контур оценки связывает генерацию с конкретными ограничениями и критериями.
Evaluator не обязательно является отдельным агентом
Проверяющую роль могут выполнять:
- другая модель;
- та же LLM с иными инструкциями;
- программный тест;
- schema validation;
- бизнес-правила;
- несколько сигналов одновременно.
Паттерн определяется не числом участников, а логикой:
generate
→ evaluate
→ feedback
→ improve
Одна модель не гарантирует независимую проверку
Если генератор и проверяющая роль используют одну LLM, одинаковый контекст и похожие инструкции, их ошибки могут оказаться коррелированными.
Команда «Теперь внимательно проверь предыдущий ответ» не создаёт автоматически независимого источника истины.
Использовать одну LLM в обеих ролях можно, но для критичных случаев полезны внешние сигналы: тесты, структурные ограничения, сверка фактов или другие проверки.
Stopping conditions
Любой цикл улучшения требует условий остановки.
PASS
→ завершить

MAX ITERATIONS
→ остановить
Иногда имеет смысл хранить best-so-far, чтобы очередная итерация не заменила лучшую версию более слабой.
Лимит повторов одновременно защищает от бесконтрольного расхода токенов и роста задержки.
Типичные сбои
Bad criterion — оптимизация идёт под неверный критерий.
Evaluator blind spot — механизм оценки регулярно пропускает один тип ошибки.
Oscillation — новая версия исправляет A ценой B, а следующая возвращает проблему обратно.
Endless refinement — процесс продолжает генерировать варианты без заметного прироста качества.
Поэтому качество зависит не только от генератора, но и от корректности самого контура оценки.
Evaluator–Optimizer ≠ Agent Evals
Здесь проверка встроена в текущий runtime и влияет на конкретный ответ.
Evals отвечают за систематическую оценку качества и надёжности агента на тестовых наборах, трассировках и метриках.
Это разные уровни контроля.
Передача управления (Handoff)
Есть сценарии, где нужно изменить не маршрут и не состав работ, а того, кто дальше отвечает за процесс.
Для этого используется Handoff — передача управления другому агенту.
AGENT A
   ↓
HANDOFF
   ↓
AGENT B
После передачи новый агент становится активной ролью для следующей части взаимодействия.
Handoff ≠ Routing
Routing выбирает путь обработки.
Передача управления меняет активного владельца процесса.
Система может направить запрос в специализированный сценарий и при этом сохранить общий управляющий компонент. При handoff ответственность за продолжение переходит другой роли.
Handoff ≠ Agent-as-Tool
Если manager вызывает специалиста для одной ограниченной операции:
MANAGER
↓
SPECIALIST
↓
answer
↓
MANAGER
основное управление остаётся у manager.
При handoff:
MANAGER
↓
HANDOFF
↓
SPECIALIST = ACTIVE OWNER
новый специалист сам ведёт следующую часть процесса.
Нужен контракт передачи
Качественная передача — это не просто команда «теперь продолжай ты».
Новому агенту нужен минимальный рабочий контекст:
почему происходит передача
что уже известно
какие шаги выполнены
какой ответ получен
что остаётся сделать
какие ограничения действуют
Без этого новый специалист может повторить уже сделанное, потерять важные данные или неверно понять ситуацию.
Не менее важно явно определить ownership:
Кто теперь отвечает за следующий шаг?
Когда передача управления полезна
- triage в поддержке;
- escalation;
- перехода к узкому специалисту;
- смены доменной компетенции;
- продолжения процесса агентом с другим набором инструкций или полномочий.
Типичные failure modes
Wrong target — выбран неподходящий specialist.
Context loss — новому агенту не передана необходимая информация.
Unclear ownership — непонятно, кто теперь продолжает процесс.
Ping-pong:
Agent A
→ Agent B
→ Agent A
→ Agent B
Без ограничений два агента могут многократно передавать запрос друг другу, не приближаясь к решению. Поэтому policy должна задавать допустимые направления перехода и условия остановки.
Когда Handoff не нужен
Если специалисту требуется только выполнить одну ограниченную часть и вернуть ответ manager, передавать ownership необязательно.
Здесь проще использовать specialist как tool или ограниченную worker-role.
Перед сравнением: динамический workflow должен иметь границы
Несмотря на различия между паттернами, у production-архитектуры есть общий принцип:
Чем динамичнее поведение ИИ-агента, тем важнее заранее определить границы его работы.
Для разных механизмов они выглядят по-разному:
Routing
→ confidence / fallback

Parallelization
→ timeout / required branches

Orchestration
→ fan-out / task budget

Evaluation loop
→ max iterations / stopping rule

Handoff
→ allowed transfers / loop protection
Ограничения нужны не только ради бюджета.
Они помогают локализовать ошибку до того, как неверное решение распространится дальше:
Prompt Chaining
→ проверка блокирует плохой промежуточный output

Routing
→ fallback удерживает неоднозначный запрос

Parallelization
→ сбой одной ветви не обязан останавливать остальные

Orchestration
→ budget ограничивает неудачную декомпозицию

Evaluation loop
→ max iterations останавливает неэффективный цикл

Handoff
→ правила ownership предотвращают ping-pong
Это и есть failure containment.
Хорошая архитектура проектирует не только happy path, но и поведение агента, когда инструмент недоступен, входных данных мало, проверка не пройдена или агент может принять неправильное решение.
Сравнение шести паттернов: latency, cost и контроль
Паттерны решают разные архитектурные проблемы, поэтому рейтинг «лучше — хуже» здесь не работает.
Полезнее сравнивать, какой тип управления добавляется и насколько предсказуема структура процесса.
| Паттерн | Что решает | Что фиксировано до запуска | Concurrency | Откуда появляется дополнительная работа | Predictability | Главный риск |
|---|---|---|---|---|---|---|
| Prompt Chaining | последовательные зависимости | порядок этапов | обычно нет | фиксированная цепочка calls | высокая по структуре | error propagation |
| Routing | выбор пути | набор возможных маршрутов | не обязательна | классификация + выбранный сценарий | высокая–средняя | misrouting |
| Parallelization | одновременно обрабатываемые части | состав ветвей | да | несколько calls + aggregation | высокая по topology | straggler / conflict |
| Orchestrator–Workers | динамическая декомпозиция | общая цель | возможно | анализ + fan-out + synthesis | ниже | bad decomposition |
| Evaluator–Optimizer | итеративное улучшение | критерии и stopping policy | не обязательна | дополнительные циклы проверки | зависит от policy | evaluator failure |
| Handoff | смена active owner | допустимые переходы | не ключевое свойство | передача + продолжение новой ролью | зависит от policy | wrong handoff / loop |
Это качественное архитектурное сравнение, а не benchmark.
Реальные затраты зависят от LLM, размера контекста, token usage, инструкций, вызовов инструментов и инфраструктуры.
Предсказуемость topology ≠ одинаковая стоимость каждого запуска.
Одинаковая цепочка из четырёх этапов может работать с документами разного размера и потреблять разное количество токенов.
Комментарий Анастасии Чернецкой
«Количество агентов, model calls и дополнительных проверок само по себе не делает архитектуру лучше. Каждый новый вызов увеличивает стоимость, добавляет задержку и создаёт ещё одну точку, где процесс может пойти не так. Поэтому я бы оценивала не то, насколько схема выглядит “агентной”, а что конкретно даёт каждый дополнительный шаг: снижает ошибку, ускоряет работу, улучшает качество или позволяет решить задачу, которую нельзя было надёжно выполнить проще».
Паттерны можно комбинировать
Реальная агентная система не обязана использовать только один способ организации процесса.
Например:
INPUT
  ↓
ROUTING
  ↓
ORCHESTRATOR
  ↓
┌→ WORKER A ─┐
├→ WORKER B ─┼→ AGGREGATE
└→ WORKER C ─┘
  ↓
EVALUATOR
  ↓
RESULT
Сначала выбирается маршрут. Затем система динамически определяет необходимые части. То, что не требует ответа соседней ветви, выполняется параллельно. После сборки итог проходит проверку.
Это нормальная композиция.
Проблема возникает, если каждый новый слой появляется не из требований процесса, а из желания сделать систему «более агентной».
LLM ROUTER
→ LLM PLANNER
→ ORCHESTRATOR
→ 7 WORKERS
→ EVALUATOR
→ HANDOFF
Такая конструкция добавляет:
- новые инструкции;
- дополнительные model calls;
- больше передаваемого контекста;
- расход токенов;
- больше переходов состояния;
- дополнительную задержку;
- новые failure points;
- более сложный контроль.
Полезный complexity test:
маршрутизатор почти не принимает реальных решений?
→ заменить правилом

декомпозиция всегда одинакова?
→ зафиксировать процесс кодом

проверка почти всегда PASS с первой попытки?
→ проверить, нужен ли отдельный цикл
Если динамический компонент почти не влияет на реальное поведение, его трудно оправдать.
Комментарий Анастасии Чернецкой
«Самая частая ошибка сложных agentic-схем, на мой взгляд, — начинать проектирование с набора технологий вместо самой задачи. Сначала добавляют router, потом orchestrator, нескольких workers, evaluator и handoff, а уже после пытаются объяснить, зачем нужен каждый слой. Я бы шла наоборот: сначала фиксировала реальные зависимости и точки неопределённости в процессе, а затем добавляла только тот паттерн, который закрывает конкретную проблему. Архитектура должна усложняться вслед за задачей, а не опережать её».
Поэтому выбирать стоит не один паттерн для всей системы, а подходящий механизм для каждой конкретной части процесса.
Как выбрать паттерн: короткая модель решений
Полезнее не строить линейный рейтинг из шести вариантов, а разделить выбор на два уровня.
Этап 1. Выбрать базовую форму выполнения
Порядок зависимых шагов фиксирован?
├── Да → Prompt Chaining
└── Нет
     ↓

Есть ограниченный набор возможных маршрутов?
├── Да → Routing
└── Нет
     ↓

Есть части, которые можно выполнить одновременно?
├── Да → Parallelization
└── Нет
     ↓

Состав дальнейших работ определяется
только по ходу процесса?
└── Да → Orchestrator–Workers
Этап 2. Проверить дополнительные требования
Нужен повторяющийся цикл улучшения
по проверяемому критерию?
→ добавить Evaluator–Optimizer

Нужно передать дальнейшее управление
другому специалисту?
→ добавить Handoff
Это не официальный стандарт и не универсальный algorithm.
Главная функция этой схемы — определить структуру неопределённости.
Полезно последовательно спросить:
- можно ли зафиксировать порядок шагов кодом;
- ограничен ли набор возможных маршрутов;
- какие части могут обрабатываться одновременно;
- должен ли агент сам определять дальнейший план;
- можно ли формально проверить качество ответа;
- требуется ли смена active owner.
Чем больше решений можно описать правилами, тем меньше динамической оркестрации требуется агенту.
Когда сложному workflow не нужен сложный ИИ-агент
Большой процесс сам по себе не требует сложной агентной архитектуры.
Например:
получить данные
→ проверить формат
→ классифицировать
→ создать документ
→ отправить на согласование
Этапов много, но их логика стабильна.
LLM здесь может:
- извлекать данные;
- классифицировать текст;
- генерировать документ;
- проверять отдельные поля.
Но ход процесса всё равно определяет программа.
Такой подход часто удобнее, если:
- правила стабильны;
- число сценариев ограничено;
- ошибки дороги;
- одинаковые входы должны обрабатываться воспроизводимо;
- ИИ нужен только на отдельных этапах автоматизации.
Model-driven orchestration оправдана, когда новый контекст действительно меняет дальнейший путь: нельзя заранее определить состав работ, подходящего специалиста, число итераций или следующий шаг.
Поэтому архитектурная сложность должна соответствовать структуре неопределённости процесса.
Не каждому workflow нужен отдельный оркестратор. Не каждый ответ требует цикла оценки. Не каждый specialist должен превращаться в самостоятельного ИИ-агента.
Иногда лучшая архитектура — предсказуемый процесс, где модель используется только там, где обычной логики действительно недостаточно.
Подберите AI-сервис под свою задачу
В каталоге BestPromptAI собраны AI-сервисы для работы с текстом, данными, автоматизацией и другими рабочими сценариями.
Главный вывод
Четыре паттерна определяют базовую организацию процесса:
KNOWN DEPENDENT SEQUENCE
→ Prompt Chaining

KNOWN ROUTES
→ Routing

PARALLEL WORK
→ Parallelization

DYNAMIC DECOMPOSITION
→ Orchestrator–Workers
Два дополнительных механизма отвечают за контроль качества и ownership:
ITERATIVE QUALITY LOOP
→ Evaluator–Optimizer

TRANSFER OF ACTIVE OWNERSHIP
→ Handoff
Эти элементы можно комбинировать.
Поэтому главный вопрос не:
«Какой один из шести паттернов выбрать?»
а:
Какой механизм должен управлять каждой частью процесса и действительно ли там требуется дополнительная динамичность?
Хорошая архитектура ИИ-агента — не та, где больше моделей, агентов и слоёв оркестрации, а та, где код, модель, инструменты и агент разделяют ответственность в соответствии с реальной структурой процесса.
FAQ
Какой паттерн ИИ-агента выбрать?
Сначала определите базовую логику процесса. Для фиксированной последовательности подходит Prompt Chaining, для выбора одного из предусмотренных маршрутов — Routing, для одновременной обработки нескольких частей — Parallelization, а для динамического определения состава работ — Orchestrator–Workers. Затем отдельно решите, нужен ли Evaluator–Optimizer и передача управления через Handoff.
Обязательно ли сложному workflow несколько ИИ-агентов?
Нет. Один агент может выполнять несколько ролей, последовательно использовать разные инструкции, вызывать инструменты и участвовать в нескольких стадиях процесса. Сложная схема сама по себе не требует multi-agent architecture.
Чем Routing отличается от Handoff?
Routing выбирает предусмотренный путь обработки. Handoff передаёт активное управление другому агенту. Поэтому выбор маршрута и смена владельца процесса — разные архитектурные операции.
Чем Parallelization отличается от Orchestrator–Workers?
При Parallelization состав одновременно выполняемых частей определён до запуска. В Orchestrator–Workers сначала выполняется динамическая декомпозиция, а уже затем отдельные части при необходимости могут идти параллельно.
Может ли оркестратор запускать workers параллельно?
Да. Декомпозиция и параллельное исполнение отвечают на разные вопросы. Оркестратор формирует состав работы, после чего несколько workers могут обрабатывать свои части одновременно.
Parallelization всегда быстрее и дешевле?
Нет. Она может уменьшить время ожидания, но количество model calls не исчезает. Дополнительно требуется aggregation, а медленная ветвь способна задержать общий итог.
Evaluator обязательно должен быть отдельным агентом?
Нет. Проверку может выполнять другая модель, та же LLM с отдельными инструкциями, программный тест или несколько механизмов одновременно. Главное — проверяемый критерий и feedback loop.
Можно ли комбинировать несколько паттернов ИИ-агентов?
Да. Routing может привести запрос в динамическую оркестрацию, часть процесса затем выполняется параллельно, а итог проходит цикл оценки. Каждый дополнительный механизм должен решать отдельную архитектурную проблему.
Чем Evaluator–Optimizer отличается от evals ИИ-агента?
Evaluator–Optimizer участвует в текущем выполнении и помогает исправить конкретный ответ. Evals используются для систематической оценки качества и надёжности агента на тестовых данных, трассировках и метриках.